메뉴
퀴즈

퀴즈) 휴가자가 가장 많은 날짜찾기

e
8월 27일 조회 197

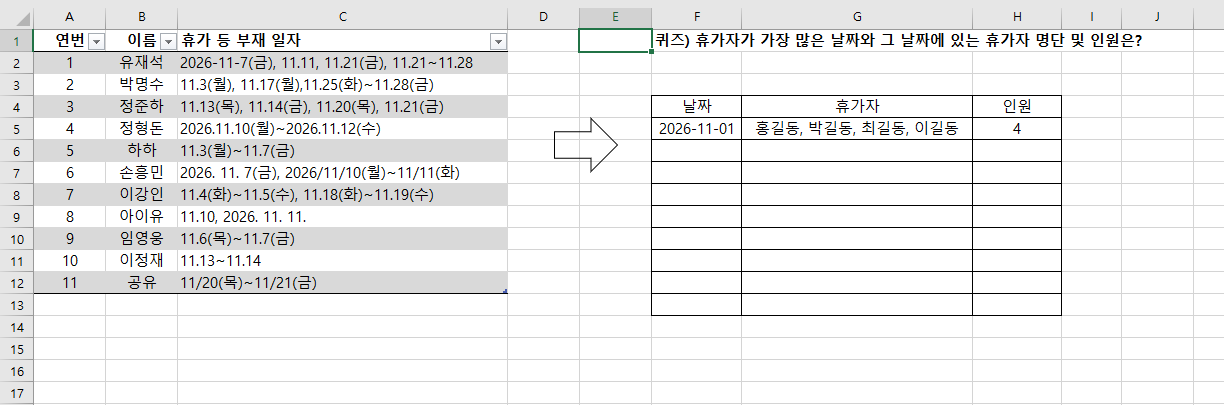
팀별로 11월 휴가일정을 수합했는데...

날짜 형식이 제각각인 자료에서

퀴즈)

휴가자가 가장 많은 날짜와 

그날 휴가자와 인원은 어떻게 되는지?

(실무에서 이런 경우가 있어서 한번 내봅니다.)
댓글 9

더블유에이 8월 27일
=LET(n,B2:B12,m,C2:C12,LET(v,TEXTSPLIT(TEXTJOIN(",",,TOCOL(n&"+"&DROP(REDUCE("",m,LAMBDA(a,b,VSTACK(a,DATEVALUE(SUBSTITUTE(REGEXEXTRACT(INDEX(b,1),"(?:\d{4}\s*[./-]\s*)?\d{1,2}\s*[./-]\s*\d{1,2}",1),".","/"))))),1),3)),"+",","),r,IFERROR(v*1,v),GROUPBY(INDEX(r,,2),INDEX(r,,1),HSTACK(ARRAYTOTEXT,COUNTA))))

e
exceller1 작성자 8월 27일

@더블유에이 님 유재석, 하하 일부 휴가일이 미반영되었네요...

원조백수 8월 27일

함정이 많네요...
휴가일자가 구간으로 표시된 것,
유재석 휴가일자에 11/21일 중복이 있는 것,
휴가 날짜끝에 쓸데 없는 "."추가된 것 등

fX 우선 정규식으로 날짜 형식을 정리하고,
    날짜와 날짜 구간을 분리해 처리하여
    날짜 1개 짜리로 나열하고,

HL 이걸 날짜 목록으로 나누고 중복을 제거하고, 각 날짜에 휴가자 이름을 붙이고,

GroupBy로 통계, 이름CountA 역순으로 정렬

=LET(DN, B2:B12, DD, C2:C12,
fX, LAMBDA(x, LET(D,REGEXREPLACE(REGEXREPLACE(x&",","\.|/","-"),"\(\D\)|\s|-,",""),
DA, REGEXREPLACE(D,"[\d{4}\-]*\d{1,2}\-\d{1,2}~[\d{4}\-]*\d{1,2}\-\d{1,2}",""),
DB, IFERROR(TEXTJOIN(",",,TEXT(TEXTSPLIT(DA,",",,1)*1,"YYYY-MM-DD")),""),
DR, IFNA(REGEXEXTRACT(D,"[\d{4}\-]*\d{1,2}\-\d{1,2}~[\d{4}\-]*\d{1,2}\-\d{1,2}",1),""),
DT, DATEVALUE(DROP(REDUCE("",DR,LAMBDA(t,v,VSTACK(t,TEXTSPLIT(v,"~")))),1)),
DS, TEXTJOIN(",",,BYROW(DT,LAMBDA(r,TEXTJOIN(",",,TEXT(SEQUENCE(INDEX(r,2)-INDEX(r,1)+1,,INDEX(r,1)),"yyyy-mm-dd"))))),
TEXTJOIN(",",,DB,IFERROR(DS,"")))),
HL, DROP(REDUCE("", SEQUENCE(ROWS(DN)), LAMBDA(t,v, VSTACK(t, EXPAND(UNIQUE(TEXTSPLIT(fX(INDEX(DD,v)),,",",1)*1),,2,INDEX(DN,v))))),1),
GROUPBY(INDEX(HL,,1),INDEX(HL,,2),HSTACK(LAMBDA(x, TEXTJOIN(",",,x)),COUNTA),0,0,-2))

e
exceller1 작성자 8월 27일

@원조백수 님 이 퀴즈를 수식으로 하면 이렇게 복잡할 줄 몰랐습니다....

정규식은 파워쿼리가 편하다는 걸 다시 한번 느껴봅니다..

원조백수 8월 28일

줄여도 이정도 뿐이네요.

=LET(NM, B2:B12, HL, C2:C12,
fX, LAMBDA(x, LET(DR, TEXTSPLIT(x,"~"),
BYROW(DR, LAMBDA(r, TEXTJOIN(",",,TEXT(SEQUENCE(IFERROR(INDEX(r,2),INDEX(r,1))-INDEX(r,1)+1,,INDEX(r,1)),"mm-dd")))))),
HD, REGEXREPLACE(REGEXREPLACE(HL&",", "\(.\)|2026[-\./]|\s|\.,",""),"[\./]","-"),
DD, MAP(HD, LAMBDA(x, TEXTJOIN(",",,REDUCE("", TEXTSPLIT(x,,",",1), LAMBDA(t,v, VSTACK(t, fX(v))))))),
DN, MAP(SEQUENCE(ROWS(HD)), LAMBDA(r, REGEXREPLACE(INDEX(DD,r)&",", ",",","&INDEX(NM,r)&"|"))),
DL, UNIQUE(TEXTSPLIT(CONCAT(DN),",","|",1)),
DROP(GROUPBY(TAKE(DL,,1)*1, TAKE(DL,,-1), HSTACK(LAMBDA(x, TEXTJOIN(", ",,x)), COUNTA),0,0,-3),1))

e
exceller1 작성자 8월 31일
삭제된 댓글입니다.
원조백수 8월 31일

@exceller1 님 파워쿼리에 익숙하셔서 그렇지 전~~혀 쉬워보이지 않습니다...
그리고 유재석 11/21일 중복 등록이 있어서 중복제거가 한 번 필요합니다^^

e
exceller1 작성자 8월 31일

@원조백수 님 파워쿼리로 만들어 봅니다.

중복된 항목 제거 추가..깜박했네요...ㅎㅎ

마법의손 6일 전

역시 너무 복잡한건 파워쿼리로 처리해줘야함..^^

저는 EGTools의 explode를 이용해서 처리해봤습니다.

이용을 했는데도 퀴즈의 좀 긴 수식 길이만큼이네요

=LET(Data, EXPLODE(SUBSTITUTE(B2:C12," ",""),2,","),
날짜,REGEXREPLACE(SUBSTITUTE(TRIM(SUBSTITUTE(INDEX(Data,,2),"."," "))," ","-"),"\([월화수목금토일]\)",""),
fx,LAMBDA(str,LET(s,--TEXTBEFORE(str,"~"),e,--TEXTAFTER(str,"~"),TEXTJOIN(",",1,SEQUENCE(e-s+1,,s)))),
uData,UNIQUE(EXPLODE(HSTACK(INDEX(Data,,1),MAP(날짜,LAMBDA(m,IFERROR(--m,fx(m))))),2,",")),
gData,GROUPBY(--INDEX(uData,,2),INDEX(uData,,1),ARRAYTOTEXT,0,0),
HSTACK(gData,MAP(INDEX(gData,,2),LAMBDA(m,ROWS(TEXTSPLIT(m,,",",TRUE))))))

이야기 게시판의 최근 글

스크랩 완료